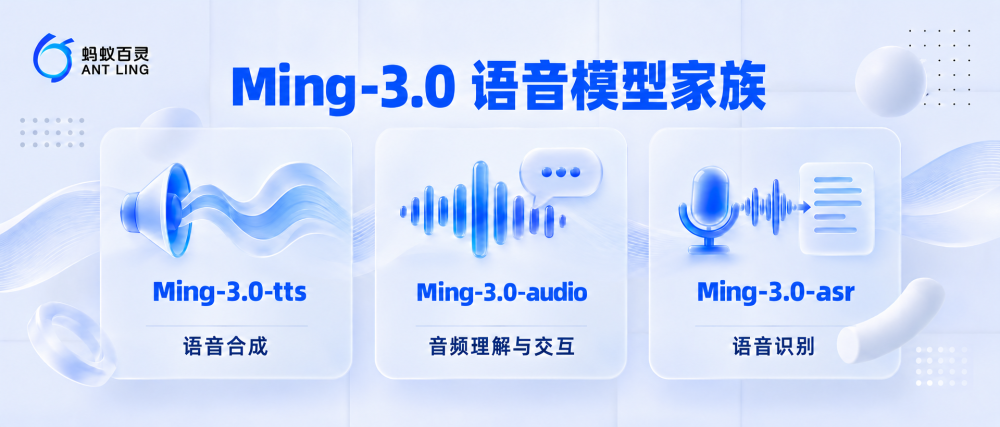
10 月 20 日,蚂蚁百灵宣布开源 Ming-3.0 语音系列,一共五款模型,分成语音合成、音频理解与对话、语音识别三个方向,权重已上架 Hugging Face 与 ModelScope,也可以通过官方平台提供的接口调用。
三条线分别管什么
合成侧有 tts 的 0.5B 与 tiny 两档,支持用文字描述目标音色,也支持传一段参考录音做音色克隆;「导演模式」可以把情绪转折、重读词、说话节奏写成自然语言一并提交,文本里还能插入行内标签,指定笑声、叹息、咳嗽出现的位置。
理解侧有 audio 的 flash 与 tiny,参数量分别是 126B(每 Token 激活 6.5B)和 9.3B(激活 2.7B),跳过了先转写再分析的旧流程,直接对长录音做转写、总结、观点抽取并结构化输出,同时保留说话人、情绪与环境信息。识别侧是 asr-tiny,可以在识别时传入热词表和对话上文,辅助判断地名、术语和同音词,不需要额外微调。
官方给出的分数
按官方披露:tts-0.5B 在发音鲁棒性上拿到 93.2%,并列第一;语音可控性榜单 1069 Elo,列开放权重模型第一。audio-flash 在 MMAU 得 82.00、VoiceBench 得 86.74、语音推理基准 BigBenchAudio 得 99.40。asr-tiny 在领域词、方言、中英文四类场景平均错误率 4.41%。这些均为厂商自测口径。
需要提醒的是,开放权重不等于能在普通电脑上跑:官方给 audio-flash 的参考部署配置要多张 80GB 显存的 H800。
对普通用户意味着什么
做短视频配音、会议纪要、客服录音分析的团队,现在可以按需拼装:合成负责好听,理解负责听懂长录音,识别负责把方言和专业词转准。这套能力已在阿福 App、支付宝搜索、安全核身等业务里跑过,属于有真实场景验证的一批开源模型。
关于本文
本文为 转载/编译 内容,原发于 腾讯新闻 (原文时间 2026-10-20)。标题与表述可能经中文编译处理,事实以原文为准。
查看原文 →