10 月 19 日,Inception 发布 Mercury 3,这是它第四代扩散语言模型。和 GPT、Claude 这类逐字往外吐的模型不同,扩散模型先一次性写出一整版草稿,再并行地反复修,理论上更适合压延迟。
具体数字
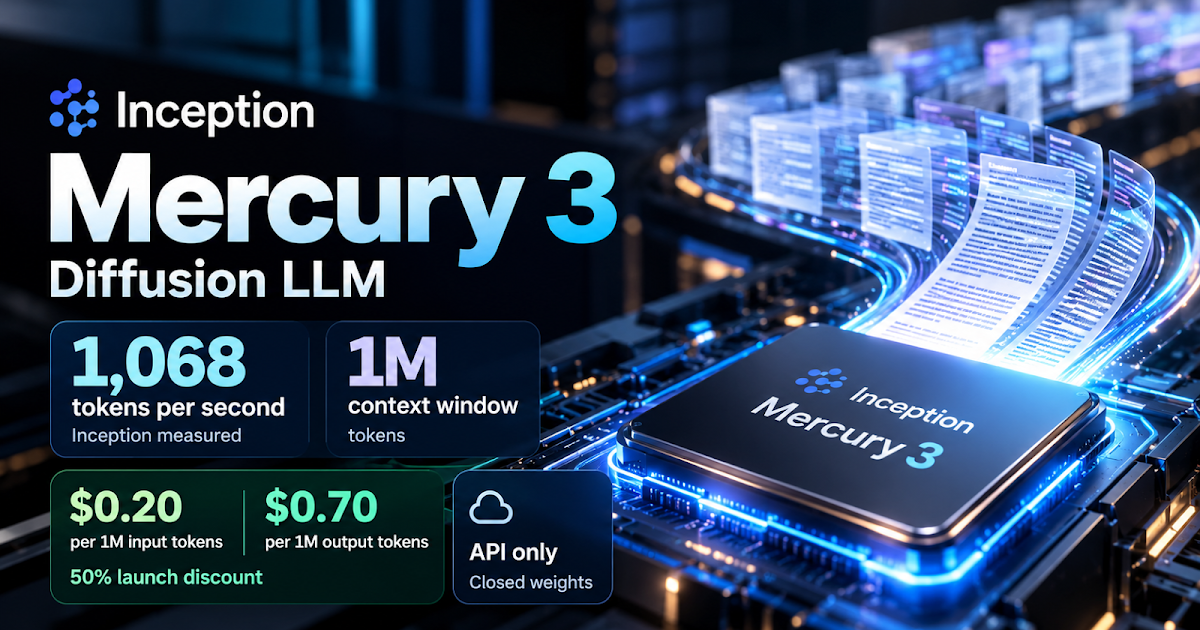
官方给出的关键指标是:在常见英伟达显卡上生成速度超过每秒 1000 Token(实测值 1068);上下文窗口从上代的 26 万 Token 扩到 100 万;整体规模比第一代 Mercury 大约 40 倍,速度却没掉。
定价为每百万输入 Token 0.20 美元、每百万输出 Token 0.70 美元,发布期五折,即 0.10 与 0.35 美元,命中缓存的输入再打九折。可以通过 Inception 自己的接口以及 Baseten、OpenRouter、Vercel 调用,接口格式与 OpenAI 兼容,换模型基本不用改代码。
成绩单要打个折看
Inception 称在 12 项标准评测中有 8 项领先 GPT-6 Luna 与 Claude Haiku 5.5,但这是厂商自测口径,对手的分数也是它自己测的,官方没有公布完整的测试方法。合作方 TinyFish 报告 Mercury 3 在其生产环境里完成了 50 个网页导航任务中的一半,同样属于合作方自测,未经独立复测。还有一个前提:模型只提供接口调用,权重不开源,也无法自己部署。
对普通用户意味着什么
对做实时场景的人意义最直接——在线辅导、实时翻译、语音助手、需要反复调用模型的多步智能体,卡的都是等待时间。速度提上来,同一套流程能跑更多轮尝试,体验差别比排行榜上那几分更大。至于它是不是真的比闭源旗舰更聪明,等第三方复测更稳妥。
关于本文
本文为 转载/编译 内容,原发于 Business Wire (原文时间 2026-10-19)。标题与表述可能经中文编译处理,事实以原文为准。
查看原文 →