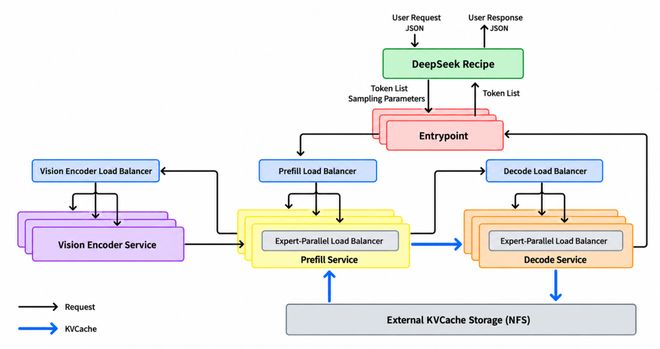
10 月 20 日,DeepSeek 宣布把支撑自家线上服务的推理框架 DeepInfer 全面开源,许可证为 Apache 2.0,同时开源了配套的 Token 编解码组件 deepseek-recipe。
开源的到底是什么
推理框架是夹在模型和显卡之间的那一层调度系统:用户每一次提问,都要靠它把算力排班、把结果拼好。DeepSeek 这次放出的版本集成了 FlashMLA、DeepGEMM、DeepEP、TileKernels 等自家算子库,支持注意力并行、MoE 专家并行与专家负载均衡,也支持推测解码、SWA 有界重放和结构化输出(正则、JSON Schema、EBNF 三种约束方式)。
硬件上明确支持英伟达 SM100(需要 CUDA 13)与华为昇腾 950(需要 CANN 9.2),底座主要基于 vLLM 开发,也借鉴了 SGLang 与 TensorRT-LLM 的设计。
关键数字
官方技术报告给出的口径是:单一集群每天服务 155 万亿 Token,单卡每小时收入 38 美元(按低谷电价折算)。目前明确支持的模型只有 DeepSeek-V4.1-Flash,开源版本提供的是离线推理能力——KV 缓存系统、预填充与解码分离部署、跨副本负载均衡这三块仍需使用者自己搭。上述吞吐与收入数字均为官方自报,尚无第三方独立复现。
对普通用户意味着什么
同一张卡能吐出多少 Token,直接决定 API 的单价。这一层被放出来,企业自建服务的成本门槛会降一档;但它不是开箱即用的部署包,想复现官方表现仍需要相当的运维能力。对只想调接口的普通用户,短期感受不深,中期更可能体现在价格上。
关于本文
本文为 转载/编译 内容,原发于 澎湃新闻 (原文时间 2026-10-20)。标题与表述可能经中文编译处理,事实以原文为准。
查看原文 →